Az algoritmus nem elfogult, csak pontosan megtanulja, amit a múltbeli döntésekben lát. Mit jelent ez a gyakorlatban, miért nem lehet a tisztességet egyetlen számmal mérni, és mit ír elő 2026-ban az AI Act egy magyar vállalatnak?
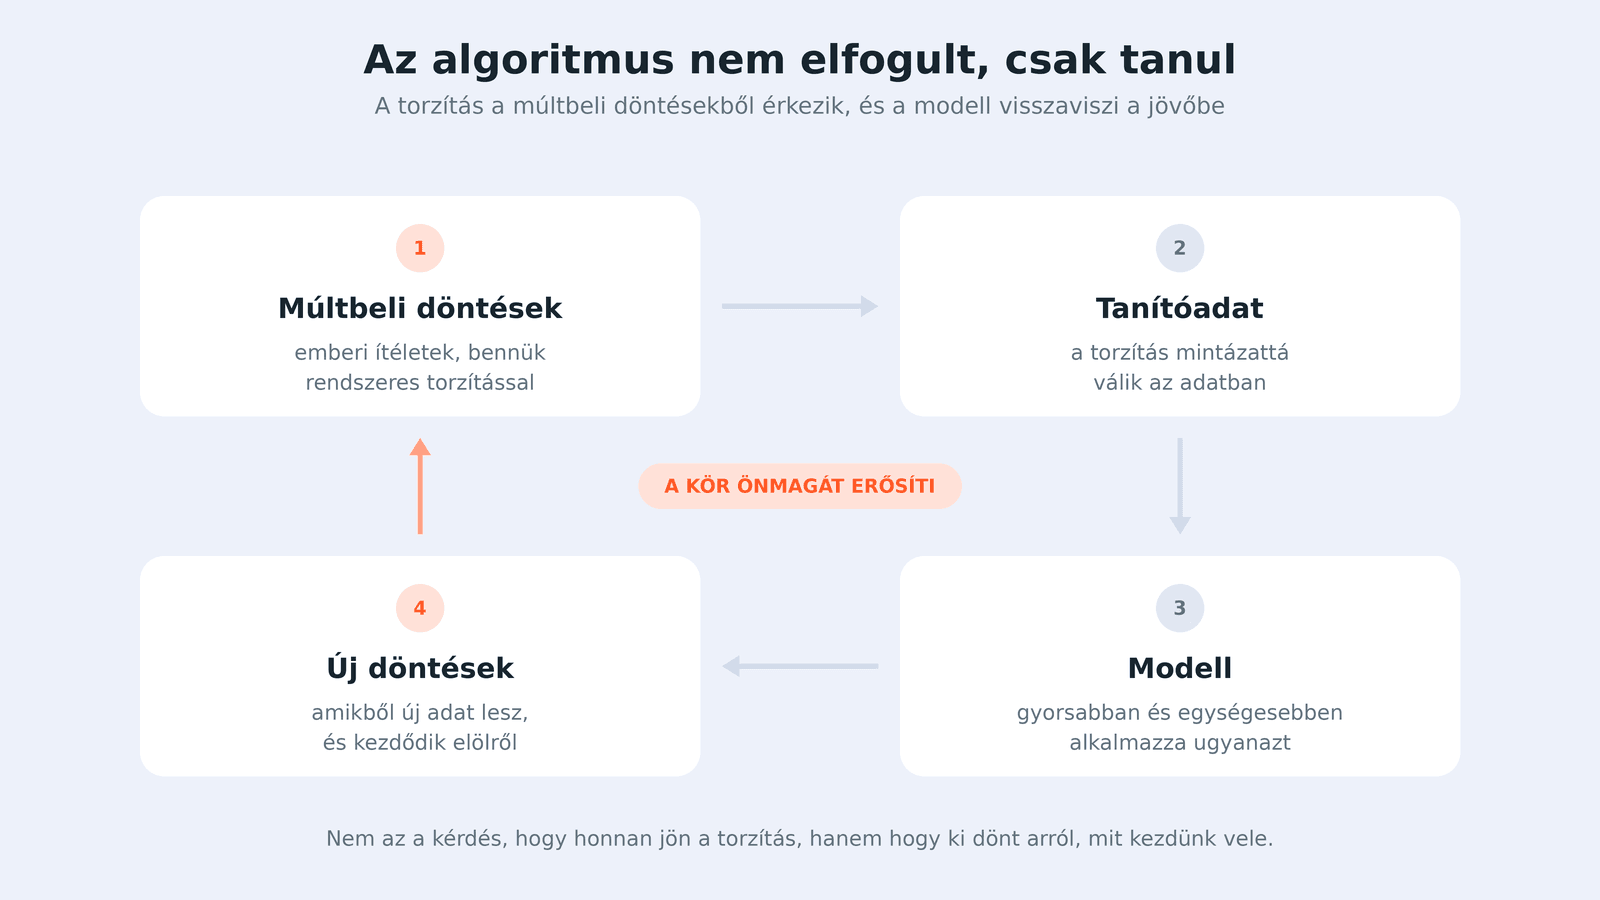
Egy modell nem elfogult. Egy modell pontosan megtanulja azt, amit a múltbeli döntésekben lát, és ha azokban a döntésekben volt rendszeres torzítás, azt fogja a jövőre vetíteni. Ez nem technikai hiba, amit egy jobb algoritmus megold, hanem tervezési kérdés, amire válaszolni kell.
A felelős AI azt jelenti, hogy egy gépi tanuláson alapuló rendszer működése végig tisztességes, átlátható és elszámoltatható. Három dologból áll: az adat és a modell torzításainak ismeretéből, a döntések magyarázhatóságából, és a jogszabályi megfelelésből. 2026-ban az Európai Unióban ez utóbbi már nem választás kérdése, hanem az AI Act kötelezettsége.
Mit jelent a felelős AI?
A fogalom három, egymástól elkülöníthető kérdésre bomlik. Hasznos külön kezelni őket, mert más-más szakember és más-más eszköz tartozik hozzájuk.
Kérdés
Mit vizsgálunk?
Ki a felelős?
Tisztességes-e?
Rendszeresen rosszabbul jár-e egy csoport a modell döntése miatt
Adattudós és üzleti tulajdonos közösen
Átlátható-e?
Meg tudjuk-e magyarázni, miért ez a döntés született
Adattudós
Megfelelő-e?
Teljesíti-e a rá vonatkozó jogi követelményeket
Jogi és compliance terület
A gyakorlatban ezek összefüggnek. Az AI Act például épp azért követeli meg bizonyos rendszereknél a dokumentációt és az emberi felügyeletet, mert a tisztességet másképp nem lehet ellenőrizni.
Amikor az algoritmus örökli az elfogultságot
A legismertebb eset a COMPAS, egy amerikai bíróságokon használt kockázatbecslő rendszer, amely azt jelezte előre, mekkora eséllyel követ el újabb bűncselekményt egy vádlott. A ProPublica 2016-os elemzése azt találta, hogy a rendszer tévedései nem egyenletesen oszlottak el a különböző bőrszínű vádlottak között.
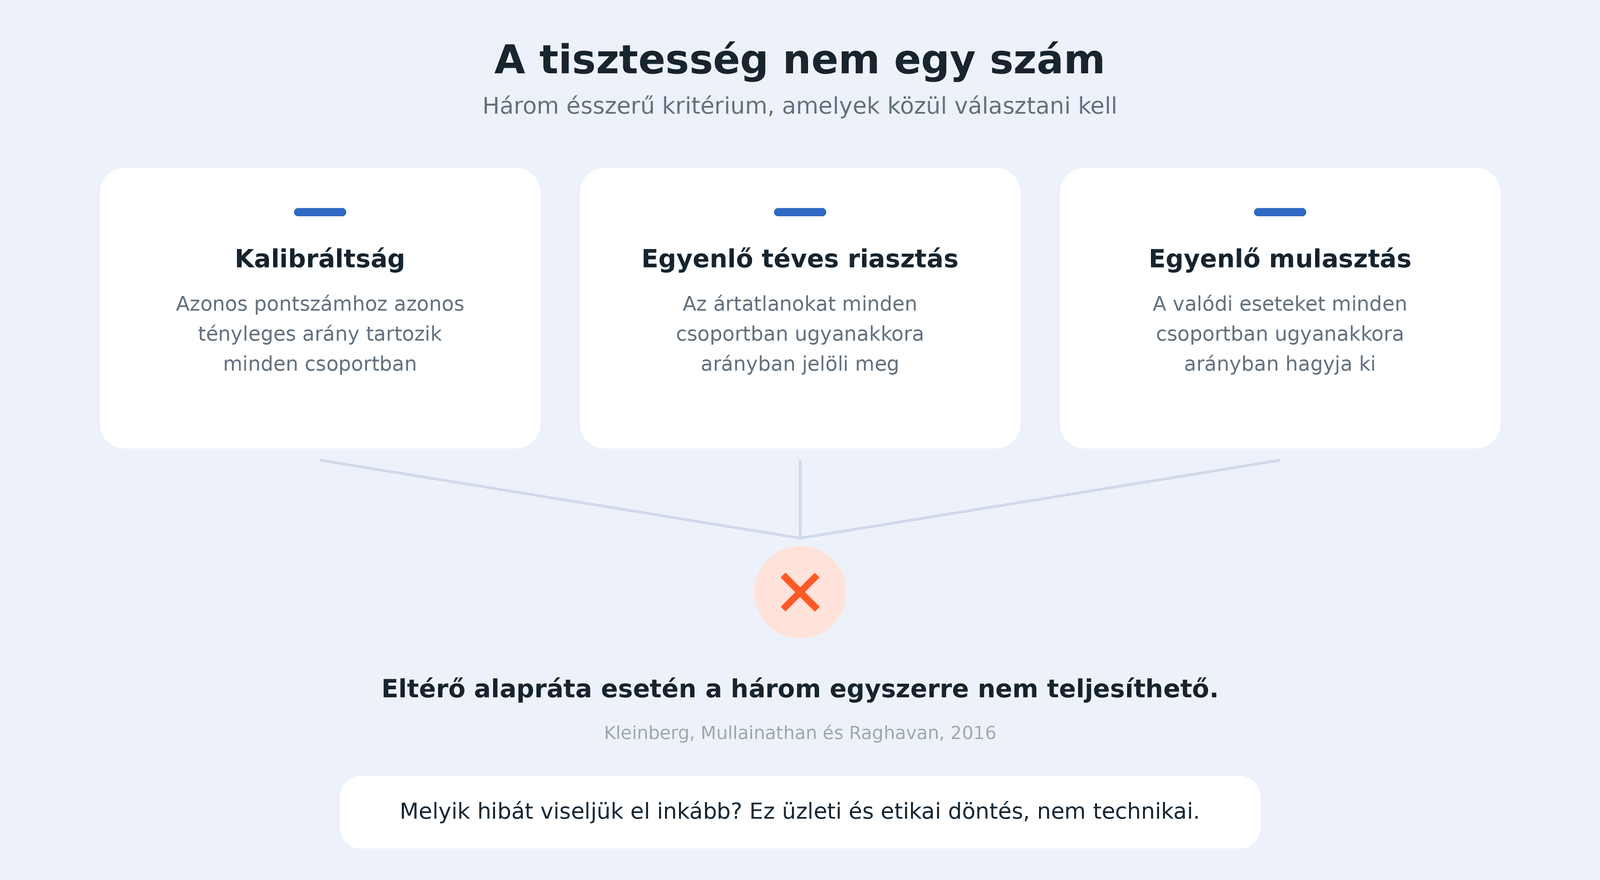
Az eset azért lett a terület alapesete, mert a fejlesztő cég válasza is védhető volt. Ők azt mutatták ki, hogy a pontszám ugyanazt jelentette minden csoportra: azonos kockázati besoroláshoz azonos tényleges visszaesési arány tartozott. Mindkét fél igazat mondott, mert két különböző tisztességfogalmat mértek.
Miért nem lehet egyszerűen kivenni a védett attribútumot?
Az első ösztön az, hogy hagyjuk ki a modellből a nemet, az életkort, az etnikai hovatartozást, és akkor nem lehet baj. Ez nem működik, két okból.
Az egyik a helyettesítő változó. Az irányítószám, az iskola neve, a munkahely, a vásárlási szokás vagy akár a mobilszolgáltató együttesen szinte tökéletesen visszaadja azt az attribútumot, amit kivettünk. A modell nem tudja, hogy tiltott információt használ, csak azt látja, hogy ezek a változók előrejelző erővel bírnak.
A másik, hogy a védett attribútum kihagyásával elveszítjük a mérés lehetőségét is. Ha nem tudjuk, ki melyik csoportba tartozik, akkor azt sem tudjuk ellenőrizni, hogy a modell egyenletesen téved-e. A gyakorlat ezért általában az, hogy az attribútumot a modell nem használja döntési változóként, de a kiértékeléshez rendelkezésre áll.
A tisztesség nem egy szám
Ez a cikk legfontosabb technikai állítása. A tisztességnek több, egyenként ésszerű matematikai definíciója van, és ezek eltérő alapráta esetén bizonyítottan nem teljesíthetők egyszerre. Kleinberg, Mullainathan és Raghavan 2016-os dolgozata pontosan ezt mutatta meg: ha a két csoportban eltérő a vizsgált esemény tényleges gyakorisága, akkor a kalibráltság és a hibaarányok kiegyenlítése kizárja egymást.
Ennek a következménye a napi munkára súlyos: a tisztességkritérium megválasztása üzleti és etikai döntés, nem technikai. Az adattudós meg tudja mutatni, mi mivel jár, de azt, hogy melyik hibát viseljük el inkább, nem ő dönti el. Ha ezt a döntést senki nem hozza meg tudatosan, akkor a modell alapbeállítása hozza meg helyettünk.
Ide kapcsolódik a magyarázható mesterséges intelligencia is: magyarázat nélkül a fenti döntés meg sem hozható, mert nem látszik, mi vezetett az eredményhez.
És ami a döntés után történik
Van egy harmadik réteg, amit a legkönnyebb elfelejteni. Egy tisztességesnek tervezett döntés hosszabb távon is javítja a helyzetet? Nem feltétlenül. A Delayed Impact of Fair Machine Learning című dolgozat azt mutatta meg, hogy bizonyos beavatkozások rövid távon kiegyenlítenek, egy idő után viszont éppen annak a csoportnak ártanak, amelyiket védeni akartak.
Ez nem érv a tisztesség ellen. Azt jelenti, hogy a modell hatását vissza kell mérni a valóságon, nem elég a bevezetéskor egyszer kiszámolni egy mutatót.
Adatetikai dilemmák a gyakorlatban
Az elfogultság csak az egyik kérdés. A másik az, hogy amit meg tudunk tenni az adatokkal, azt meg kell-e tennünk. Néhány eset, ami tíz éve is és ma is vitát vált ki:
A Target terhességi jelzése. Az amerikai áruházlánc a vásárlási szokásokból nagy pontossággal ismerte fel a terhes vásárlókat, és babatermékekkel célozta őket. Az esetet a New York Times írta meg 2012-ben, és attól lett tankönyvi példa, hogy a rendszer olyasmiről értesült, amiről a vásárló családja még nem.
Hitelbírálat. A védett attribútumok közvetlen használatát régen betiltották, mire a gyakorlat átállt olyan adatokra, amelyek ugyanazt közelítik. A tiltás önmagában nem oldotta meg a problémát, csak áthelyezte.
Dinamikus árazás. Ha a repülőjegy ára a keresési előzménytől függ, akkor ugyanazért a szolgáltatásért két ember mást fizet. Az árazás legitim üzleti eszköz, de hol a határa?
Egészségügyi kockázatbecslés. Ha egy modell megbecsüli egy műtét kockázatát, ez az információ segíti a döntést, vagy megfoszt a beavatkozás lehetőségétől?
Az ösztönző, ami nem a felhasználóé. Egy társkereső szolgáltatás optimalizálhat a sikeres párkapcsolatra, de az előfizetési időre is. A modell azt fogja maximalizálni, amit célfüggvénynek adunk, és ez a két cél nem ugyanaz.
Az első témában megjelent írásunk óta eltelt tíz évben sem tudtunk egyetemes szabályrendszert felállítani ezekre, és nem is hisszük, hogy lehetne: a legtöbb elvre található valódi ellenpélda. Amit tenni lehet, az az, hogy a konkrét eseteket kitesszük az asztalra, és a döntést nem hagyjuk a modell alapbeállítására. Ezt csináljuk belső képzéseken és ügyfélprojektekben is.
Három adatkezelési kultúra: cég, állam, egyén
A dilemmák nem légüres térben dőlnek el. Nagyjából három modell létezik arra, hogy kinek az érdeke élvez elsőbbséget az adat felhasználásánál, és ezek földrajzilag is jól elkülönülnek.
Modell
Kinek az érdeke elsődleges?
Jellemző cél
Tipikus korlát
Cégközpontú (Egyesült Államok)
A vállalaté
Hatékonyság, profit, optimalizálás
Piaci és reputációs, kevés előzetes szabály
Államközpontú (Kína)
Az államé
Ellenőrzés, megfelelés, felügyelet
Az állam saját mérlegelése
Egyénközpontú (Európai Unió)
Az egyéné
Önrendelkezés a saját adat felett
Erős előzetes szabályozás, GDPR, AI Act
Egyik ország sem tisztán az egyik modellt követi, az arány viszont más, és ez az arány meghatározza, milyen projekt kap zöld utat.
Nekünk mint európai cégnek ez nem elvont kérdés. A harmadik modell azt jelenti, hogy az adatfelhasználás jogalapja nem magától értetődő, hanem igazolni kell. Cserébe az európai adatvédelmi és AI-szabályok kiszámíthatóbbá teszik, mit szabad, és hosszú távon ez versenyelőny is lehet azoknál az ügyfeleknél, akik ezt kérdezik.
Ugyanaz az adat, két motiváció
A kultúra nem csak országokra igaz, hanem cégekre és projektekre is. Egy példa a saját munkánkból: kamionsofőrök üzemanyag-fogyasztásának elemzése.
Ugyanezt a projektet kétféleképpen lehet felvezetni. Az egyik: derítsük ki, ki pazarol, vagy ki lop. A másik: derítsük ki, mitől függ a fogyasztás, és hogyan lehet útvonallal, rakománnyal, vezetési technikával javítani rajta. Az adat ugyanaz, a modell nagyrészt ugyanaz, a projekt sorsa viszont nem.
Az első felvezetésre az érintettek védekezni kezdenek, és a bevezetés elakad. A másodikra részt vesznek benne. A Waberer's projektünkben ezért az optimalizálás volt a keret. Tapasztalatunk szerint magyar környezetben az ellenőrzési felvezetés az alapértelmezett reflex, és tudatos munka kell ahhoz, hogy ne az legyen.
Ez egyben a legolcsóbb etikai beavatkozás is, amit egy cég megtehet: nem a modell változik, hanem az, hogy mire használják. Erről bővebben az adatvezérelt döntéshozatal posztunkban írtunk.
Az EU AI Act 2026-ban: mi él már, és mi csúszott?
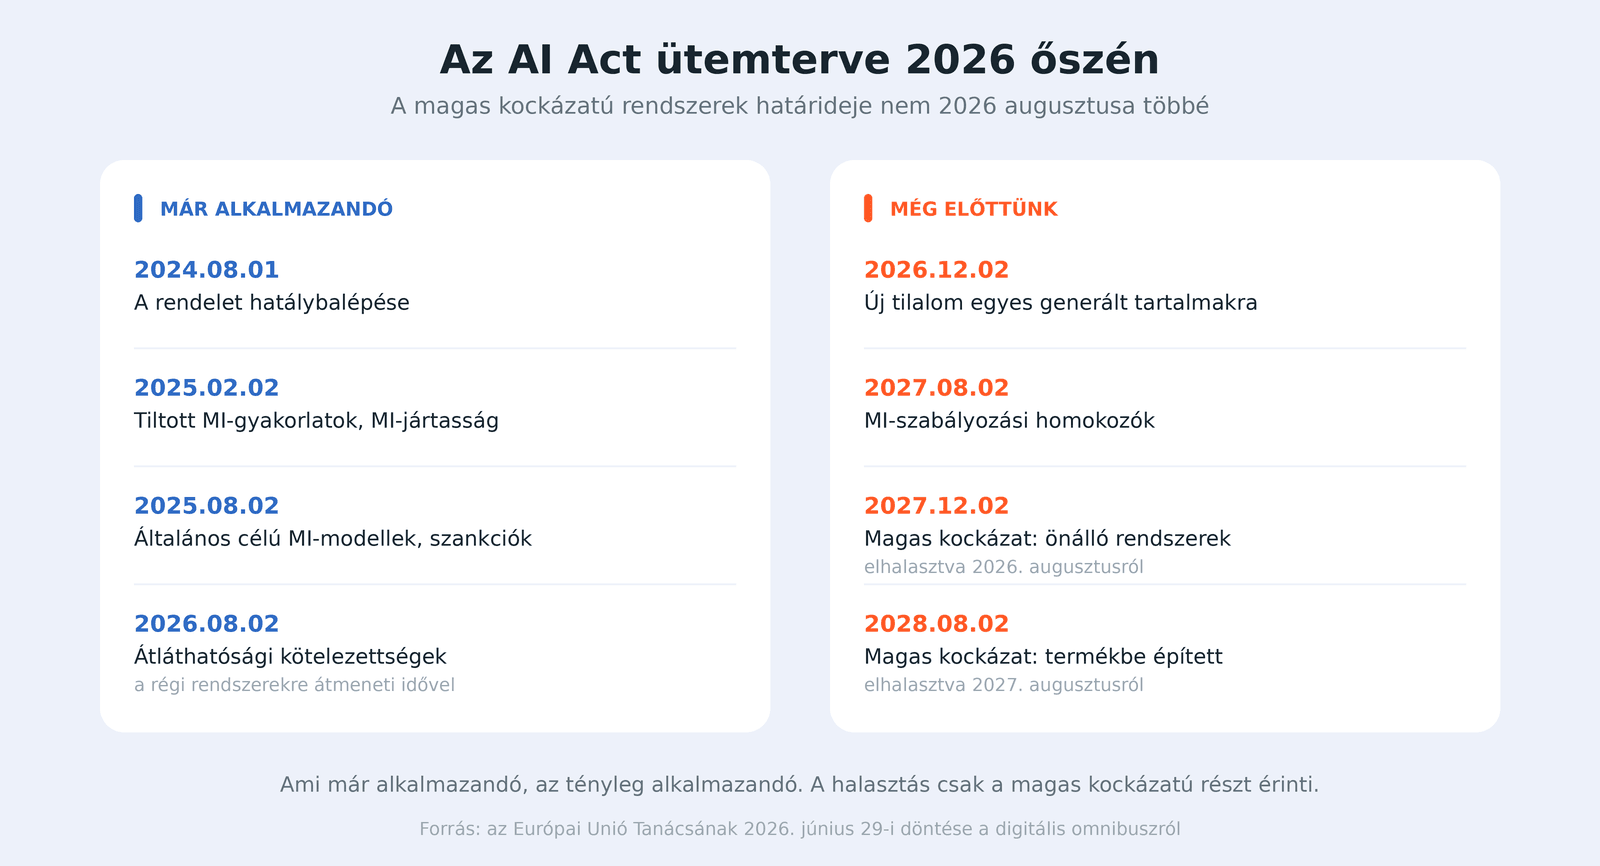
Itt érdemes lassítani, mert ebben a kérdésben sok a félreértés. Az AI Act nem egyszerre lépett hatályba, és a menetrendje 2026 nyarán megváltozott.
A rendelet 2024. augusztus 1-jén lépett hatályba, a kötelezettségek viszont szakaszosan válnak alkalmazandóvá. A magas kockázatú rendszerekre vonatkozó, legterhesebb rész eredetileg 2026. augusztus 2-án indult volna. Ez nem így történt: a Tanács 2026. június 29-én véglegesen elfogadta a digitális omnibuszt, amely ezeket a határidőket kitolta.
Általános célú MI-modellek kötelezettségei, irányítás, szankciók
Alkalmazandó
2026. augusztus 2.
Átláthatósági kötelezettségek (MI által generált tartalom jelölése)
Alkalmazandó, a korábban piacra került rendszerekre átmeneti idővel
2026. december 2.
Új tilalom a hozzájárulás nélküli intim és gyermekbántalmazási tartalmat generáló rendszerekre
Közeleg
2027. augusztus 2.
MI-szabályozási homokozók felállítása
Kitolva
2027. december 2.
Magas kockázatú, önálló rendszerek kötelezettségei
Kitolva 2026. augusztusról
2028. augusztus 2.
Termékbe épített magas kockázatú rendszerek
Kitolva 2027. augusztusról
Két tanulság ebből. Az egyik: aki azt hitte, hogy 2026 augusztusában mindenre rászakadt a szabályozás, az tévedett, van még idő felkészülni. A másik, és ez a fontosabb: ami már alkalmazandó, az tényleg alkalmazandó. A tiltott gyakorlatok tilalma másfél éve él, az MI-jártassági kötelezettség szintén, az általános célú modellekre vonatkozó szabályok pedig egy éve.
A halasztás továbbá nem feltételes és nem visszavonható automatikusan: rögzített új határidők, nem pedig egy mechanizmus, ami majd eldönti. Aki most kezd hozzá, annak nagyjából 15 hónapja van az önálló magas kockázatú rendszerekre.
Magyar végrehajtás: ki felügyel és mekkora a bírság?
A rendelet közvetlenül alkalmazandó, a végrehajtás viszont tagállami feladat. Magyarországon a 2025. évi LXXV. törvény és a 344/2025. Korm. rendelet rendezi ezt, a piacfelügyeletet pedig az MI Piacfelügyeleti Hatóság látja el, amely a Tudományos és Technológiai Minisztérium szervezeti egységeként működik.
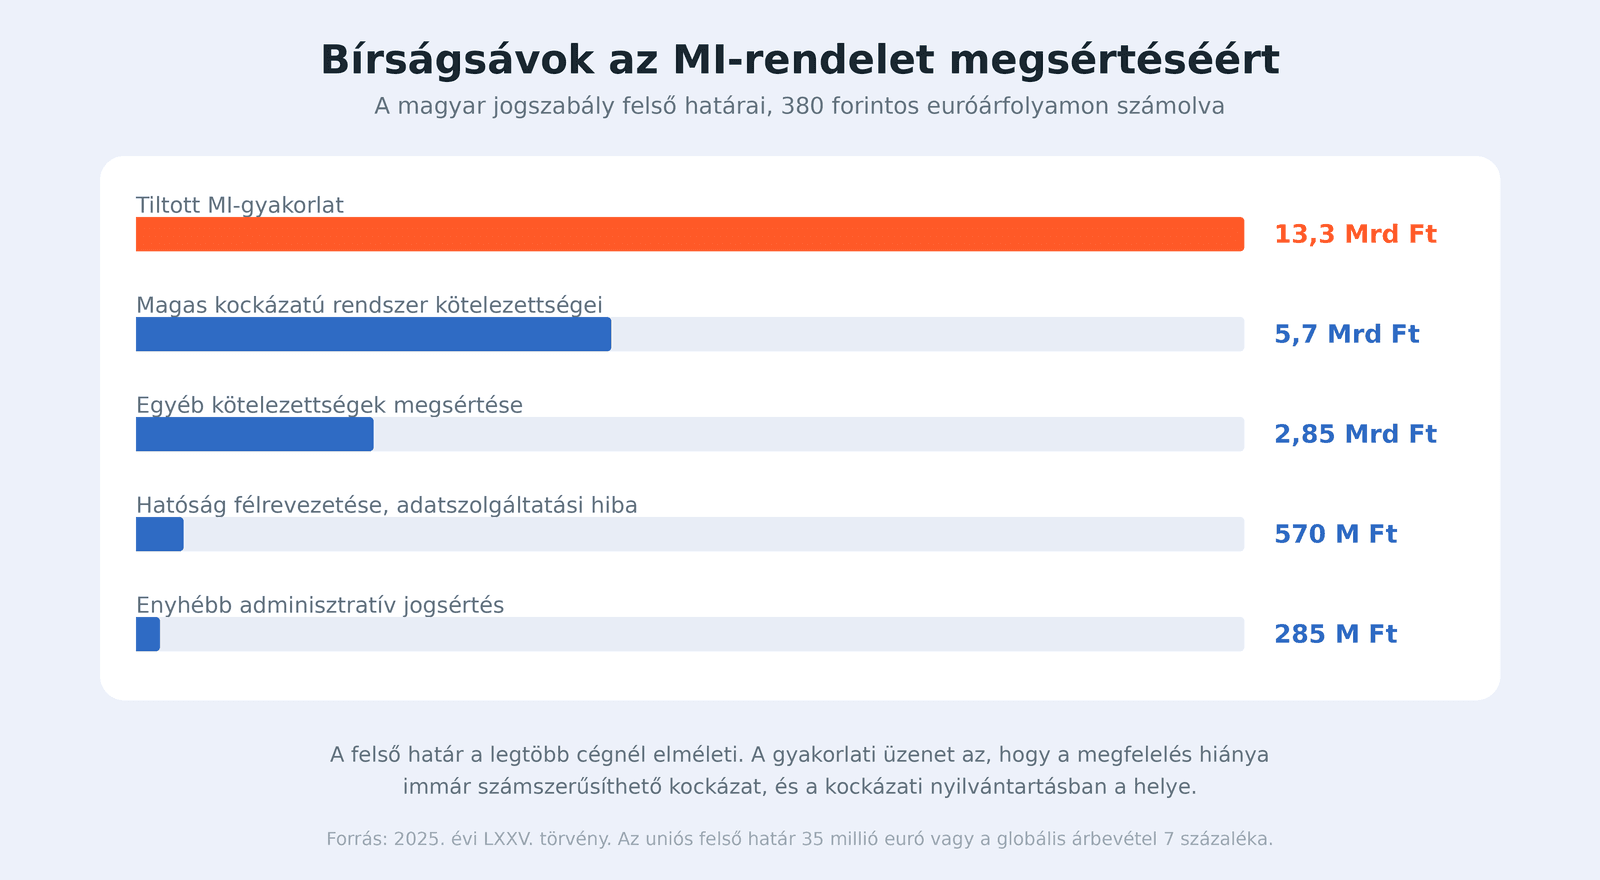
A bírságok felső határa a rendelet szerint 35 millió euró vagy a globális éves árbevétel 7 százaléka, amelyik magasabb. A magyar jogszabály ezt forintosított sávokra bontotta, 380 forintos árfolyamon számolva:
Jogsértés súlya
Bírság felső határa
Tiltott MI-gyakorlat
legfeljebb 13,3 milliárd forint
Magas kockázatú rendszerekre vonatkozó kötelezettségek megsértése
legfeljebb 5,7 milliárd forint
Egyéb kötelezettségek megsértése
legfeljebb 2,85 milliárd forint
Hatóság félrevezetése, adatszolgáltatási hiba
legfeljebb 570 millió forint
Enyhébb adminisztratív jogsértés
legfeljebb 285 millió forint
A felső határ a legtöbb magyar cégnél elméleti, a gyakorlati üzenet inkább az, hogy a megfelelés hiánya immár számszerűsíthető kockázat, és a kockázatkezelési nyilvántartásban a helye.
Mit csináljon egy vállalat? Hat lépés
Nem kell mindenkinek compliance osztályt építenie. A legtöbb magyar cégnél a következő hat lépés lefedi a lényeget, és nagy részük egyébként is hasznos.
Leltár. Írjuk össze, hol használunk MI-t. Ez szinte mindig hosszabb lista a vártnál, mert a beszerzett szoftverek beépített funkciói is idetartoznak. Ez lényegében egy szűkített adatvagyon-felmérés.
Kockázatbesorolás. Tiltott, magas kockázatú, korlátozott kockázatú vagy minimális? A legtöbb üzleti alkalmazás (előrejelzés, optimalizálás, karbantartás) nem magas kockázatú. A HR-, hitelezési, oktatási és biztonsági felhasználás viszont gyakran az.
Az adat eredetének tisztázása. Milyen döntésekből tanult a modell, és volt-e azokban rendszeres torzítás? Ez az a lépés, amit a legtöbben kihagynak, pedig ez a legolcsóbb.
A tisztességkritérium kiválasztása. Nem technikai döntés, ezért nem az adattudós hozza. Írjuk le, melyik hibát viseljük el inkább, és miért.
Dokumentáció és emberi felügyelet. Ki hagyja jóvá a döntést, mi történik felülbírálás esetén, és hol látszik utólag, mi miért történt. Ez a CRISP-DM bevezetési fázisának amúgy is része.
Visszamérés. Nem egyszeri ellenőrzés, hanem rendszeres. A modell környezete változik, és a hatása a bevezetés után alakul ki.
Hol bukik el ez a gyakorlatban?
Ugyanott, ahol a többi adatprojekt. A tapasztalatunk az, hogy a kudarc oka ritkán a modell, sokkal inkább az, hogy a szervezet nem rendelte hozzá a döntést egy felelőshöz. A felelős AI ugyanilyen: ha a tisztességkritérium megválasztása senki asztalán nincs ott, akkor nem születik meg döntés, csak alapbeállítás.
Gyakori kérdések
Mit jelent a felelős AI?
Azt, hogy egy gépi tanuláson alapuló rendszer működése tisztességes, átlátható és elszámoltatható. Három részből áll: az adat és a modell torzításainak ismerete, a döntések magyarázhatósága, és a jogszabályi megfelelés. Az Európai Unióban a harmadik részt az AI Act konkrét kötelezettségekké fordítja le.
Miért elfogult egy algoritmus?
Mert a múltbeli döntésekből tanul. Ha azokban rendszeres torzítás volt, a modell azt tanulja meg mintának, és a jövőre vetíti. A modell nem hoz új elfogultságot, hanem a meglévőt teszi gyorsabbá, egységesebbé és nehezebben megkérdőjelezhetővé.
Elég kivenni a modellből a védett adatokat?
Nem. Más változók (irányítószám, iskola, munkahely, vásárlási szokás) együttesen visszaadják ugyanazt az információt. Ráadásul a védett attribútum nélkül azt sem tudjuk ellenőrizni, hogy a modell egyenletesen téved-e. A bevett gyakorlat az, hogy a modell nem használja döntési változóként, de a kiértékeléshez rendelkezésre áll.
Mérhető-e egyetlen számmal, hogy egy modell tisztességes?
Nem. A tisztességnek több, egyenként ésszerű definíciója van, és ezek eltérő alapráta esetén bizonyítottan nem teljesíthetők egyszerre. Azt, hogy melyiket választjuk, üzleti és etikai döntésként kell meghozni, nem technikaiként.
Mikortól kell megfelelni az AI Actnek?
Szakaszosan. A tiltott gyakorlatok tilalma és az MI-jártassági kötelezettség 2025. február 2. óta alkalmazandó, az általános célú modellekre vonatkozó szabályok 2025. augusztus 2. óta, az átláthatósági kötelezettségek 2026. augusztus 2. óta. A magas kockázatú rendszerekre vonatkozó kötelezettségek a 2026 júniusában elfogadott digitális omnibusz nyomán 2027. december 2-re (önálló rendszerek), illetve 2028. augusztus 2-re (termékbe épített rendszerek) csúsztak.
Magas kockázatú-e az, amit mi csinálunk?
A legtöbb üzleti alkalmazás nem az: az előrejelzés, a készletoptimalizálás, a prediktív karbantartás vagy az energiamenetrendezés általában nem tartozik ide. A rendelet a természetes személyeket érintő, jelentős következményekkel járó felhasználásokat sorolja a magas kockázatú kategóriába, például a munkaerő-kiválasztást, a hitelbírálatot, az oktatási értékelést vagy egyes biztonsági alkalmazásokat.
Ki felügyeli ezt Magyarországon?
Az MI Piacfelügyeleti Hatóság, amely a Tudományos és Technológiai Minisztérium szervezeti egysége. A jogi keretet a 2025. évi LXXV. törvény és a 344/2025. Korm. rendelet adja.
Következő lépés
Ha nálatok most merül fel a kérdés, hogy hol tartotok ezzel, a leltár és a kockázatbesorolás néhány hét alatt elkészül, és utána látszik, kell-e bármit csinálni egyáltalán. Sok cégnél a válasz az, hogy a jelenlegi felhasználás nem magas kockázatú, és ez is értékes információ, mert leveszi a napirendről.
Majdnem minden cég használ már valahol AI-t, de kevesebb mint fele jutott el odáig, hogy működő rendszerként fusson. Az ötlépcsős modell arról szól, mi hiányzik a kettő között, és miért nem lehet lépést átugrani.
A CRISP-DM hat fázisa nem elmélet, hanem az a sorrend, amiben egy adatprojekt nem szalad félre. Végigvisszük egy banki hitelkártya-kampányon, megmutatjuk, hová megy el az idő, és hogy mi változott a bevezetés fázisában az MLOps korában.
Leíró, diagnosztikus, prediktív vagy preskriptív: négy projekttípus, négy különböző üzleti kérdésre. Táblázattal és valós projektpéldákkal ahhoz, hogy eldöntsd, a céged melyikkel induljon.