Majdnem minden cég használ már valahol AI-t, de kevesebb mint fele jutott el odáig, hogy működő rendszerként fusson. Az ötlépcsős modell arról szól, mi hiányzik a kettő között, és miért nem lehet lépést átugrani.
Majdnem minden cég használ már valahol AI-t. Sokkal kevesebben jutottak el odáig, hogy az AI működő rendszerként fusson, és még kevesebben odáig, hogy ez a mérlegen is látszódjon. A különbség nem technológiai, hanem az, hogy a bevezetés egy több lépcsős folyamat, és a lépcsők nem hagyhatók ki.
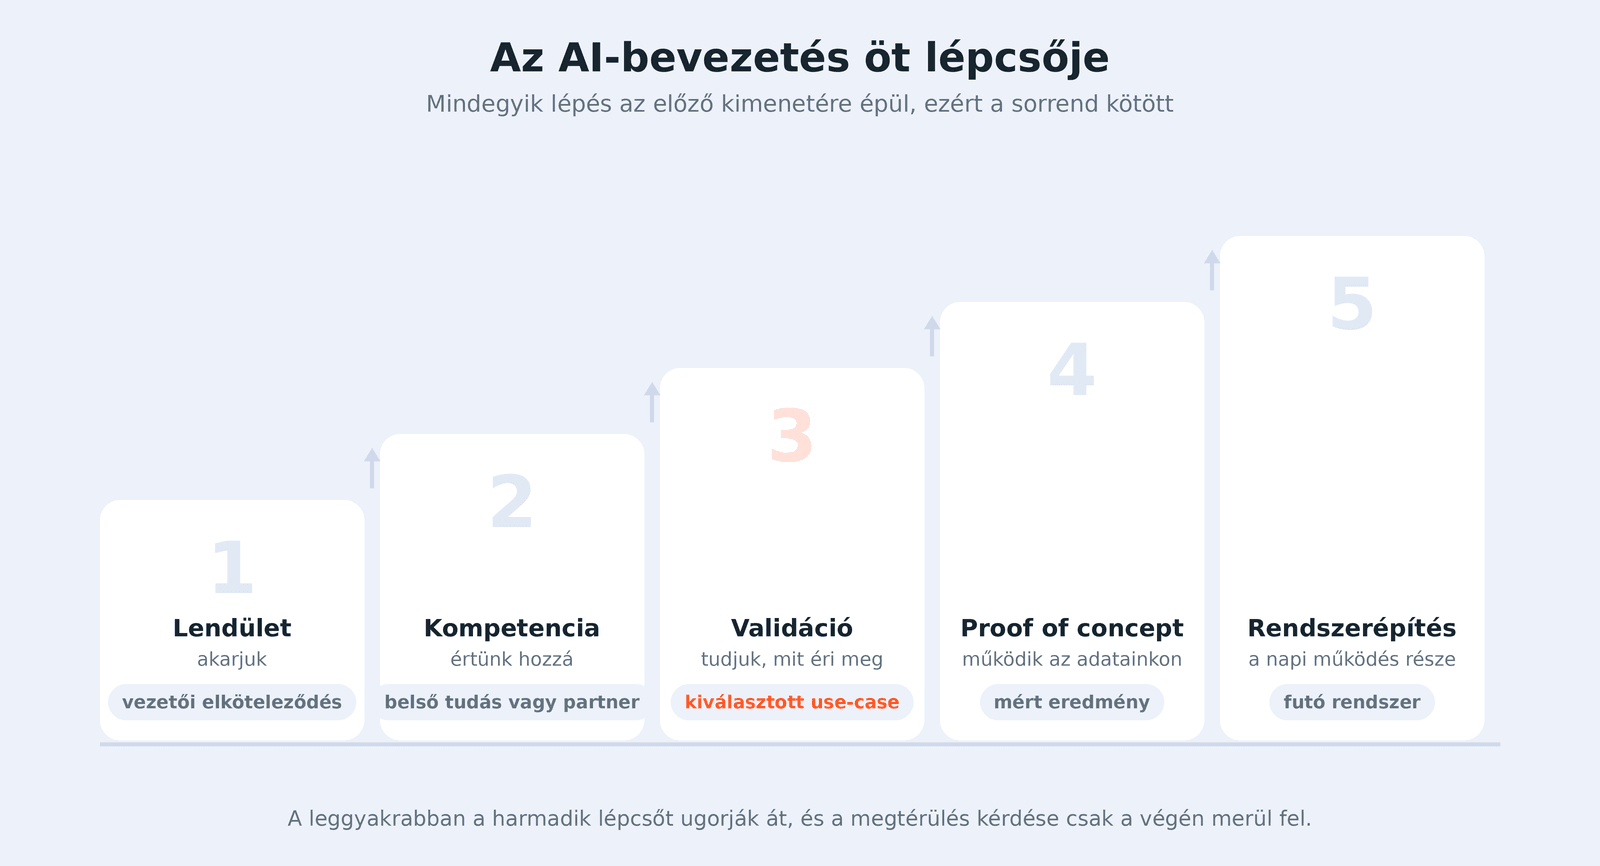
Az AI és a data science bevezetése öt lépésből áll: lendület (akarjuk), kompetencia (értünk hozzá), validáció (tudjuk, melyik folyamatot éri meg), proof of concept (kiderül, működik-e az adatainkon), végül rendszerépítés és üzemeltetés (a napi működés része lesz). A lépések sorrendje kötött, mert mindegyik az előző kimenetére épül.
Ez a modell 2018-ban készült szervezetfejlesztési műhelymunkákból, abból, ahogy az általunk kísért cégek ténylegesen végigmentek ezen az úton. Azóta a technológia sokat változott, a lépcsők nem.
Az öt lépés egy táblázatban
Lépés
Mi a cél?
Mi a kimenet?
Tipikus időtáv
A mi belépési pontunk
1. Lendület
Legyen, aki akarja, és legyen mögötte a csapat
Vezetői elköteleződés, nyitott kollégák
1-3 óra
Szemléletformáló előadás
2. Kompetencia
Legyen, aki ért hozzá
Belső tudás vagy megbízható partner
Hetek
Data science képzés
3. Validáció
Derüljön ki, melyik folyamatot éri meg
Kiválasztott use-case, becsült megtérülés
1 negyedév
Üzleti validációs workshop
4. Proof of concept és pilot
Derüljön ki, működik-e a ti adataitokon
Mért eredmény historikus adaton, majd éles próba
1-2 negyedév
Adatelemzés
5. Rendszerépítés és üzemeltetés
Legyen a napi működés része
Futó rendszer, monitorozás, visszamért érték
2+ negyedév
Rendszerépítés és üzemeltetés
Miért nem lehet lépést átugrani?
Mert minden lépés az előző kimenetéből él. Kompetencia nélkül nincs, aki megítélje, melyik use-case reális. Validáció nélkül a proof of concept egy véletlenszerűen választott feladaton méri a megtérülést. Proof of concept nélkül a rendszerépítés olyasmit automatizál, amiről senki nem tudja, működik-e.
A kihagyott lépés nem tűnik el, csak később kerül elő, jellemzően drágábban. A leggyakoribb eset az, hogy egy cég a harmadik lépést ugorja át: van lendület, van egy fejlesztőcsapat, és nekiállnak valaminek, ami jó ötletnek hangzott egy értekezleten. Fél évvel később kiderül, hogy a megoldott probléma nem az, ami a pénzt viszi.
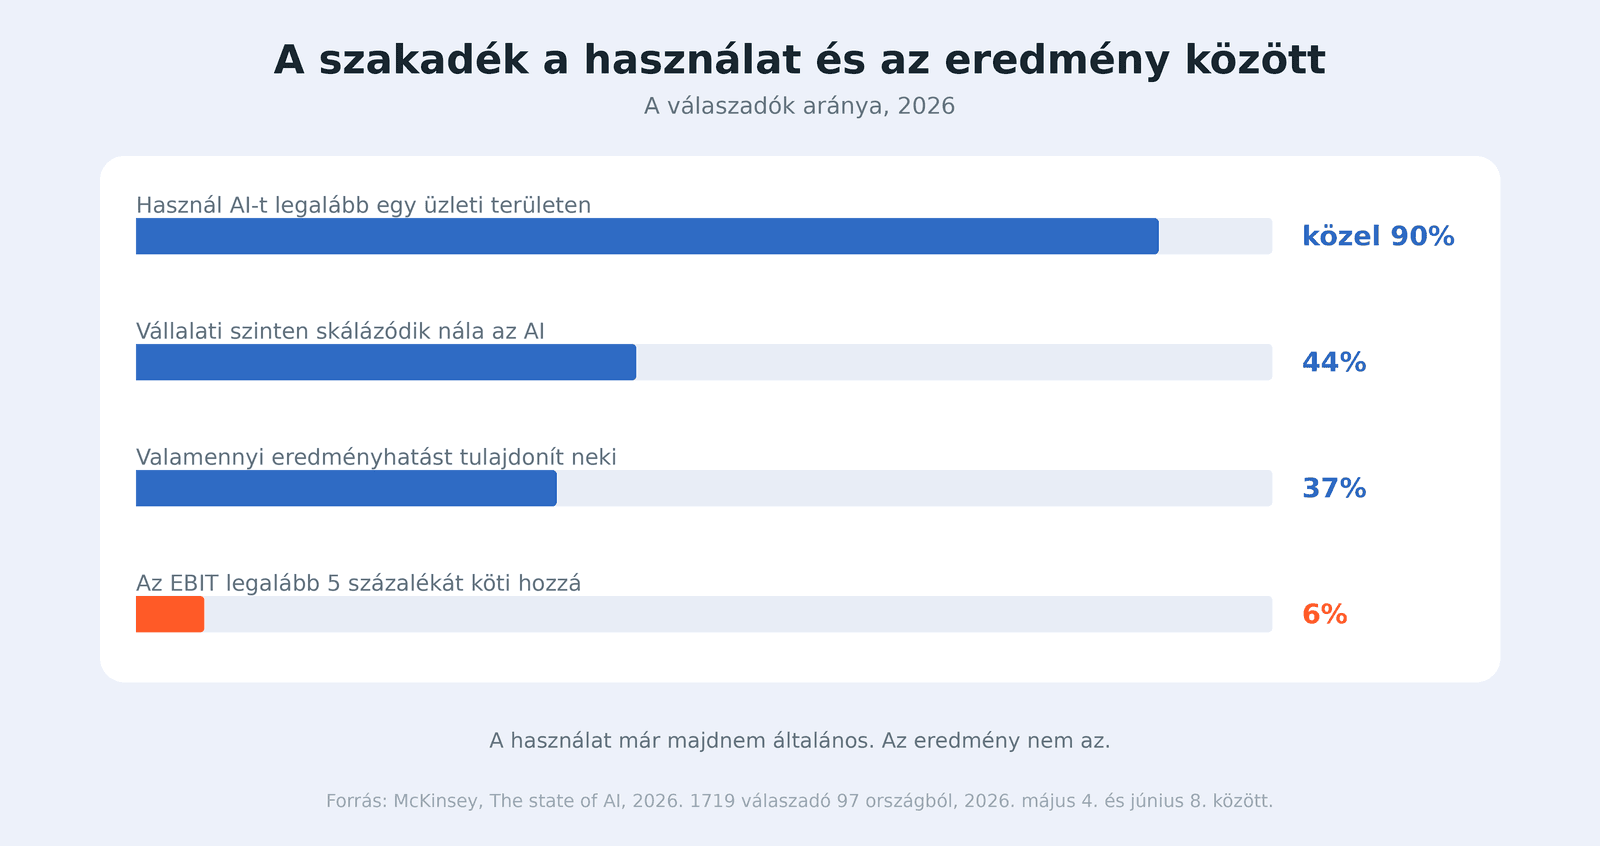
Hogy ez mennyire általános, arra van friss adat. A McKinsey 2026-os felmérése szerint (1719 válaszadó 97 országból, 2026 májusa és júniusa között) a válaszadók közel kilenc tizede használ AI-t legalább egy üzleti területen, 44 százalékuk számol be arról, hogy az AI vállalati szinten skálázódik (egy éve 38 százalék volt), 37 százalékuk tulajdonít neki valamennyi eredményhatást, de csak 6 százalék az, amelyik az EBIT legalább 5 százalékát köti az AI-hoz.
A távolság a „használunk" és a „pénzt hoz" között nem a modellek minőségén múlik. A lépcsőkön.
1. lépés, lendület: honnan jön az elhatározás?
Egy hagyományosan működő cégben ritkán van belső lelkesedés az adatvezérelt működésre, mert a meglévő folyamatok megváltoztatása mindig ellenállásba ütközik. A lendület ezért jellemzően kívülről érkezik, és két fázisban terjed.
Először egy ember lelkesedik be. Cikkből, konferencián, néha véletlenül. Aki ebben a fázisban van, annak nem szakmai dokumentációt érdemes olvasnia, hanem olyan anyagokat, ahol gyakorlati emberek mesélik el, mit változtatott náluk az adatelemzés. Jó jel, ha az anyag nem a te iparágadból való: a távolság épp azt akadályozza meg, hogy idő előtt legyintsünk rá, hogy „nálunk ez nem működne".
Klasszikus példák, amiket ma is szoktunk ajánlani: a Moneyball (hogyan épült adatból versenyképes baseballcsapat), Amy Webb előadása arról, hogyan elemezte ki a társkeresést, a Numerátorok interjúkötete, és az Information is Beautiful, ha valaki a vizualitás felől érkezik.
Utána jön a csapat. Ez más feladat, mint a saját lelkesedés, és két minta szokott működni. Az egyik alulról építkezik: egy lelkes kolléga összerak egy kisebb adatalapú eszközt egy hagyományos feladatra, és a többiek ezen keresztül látják meg, mire jó. A másik strukturált: a cég beteszi a továbbképzési programjába az inspiráló előadást, amit több terület együtt hallgat meg.
Hogy kell-e egyáltalán a második fázis, az a vezetői elköteleződésen múlik. Ha a döntéshozó mögötte áll, a szervezet gyorsabban mozdul.
Belépési pont nálunk:szemléletformáló előadás, tipikusan 1-3 óra, vegyes közönségnek. Ez a legolcsóbb lépés az egész úton, és meglepően sokszor ez dönti el, lesz-e projekt.
2. lépés, kompetencia: kit vegyél fel, és mit tanulj meg?
A lendület után jön az a kérdés, hogy ki fogja ezt csinálni. Három út van, és nem zárják ki egymást: felvétel, belső képzés, külső partner.
Amit érdemes tudni: a szűk keresztmetszet ritkán a technológiai tudás. Aki tanfolyamon megtanul modellt illeszteni, az még nem tudja megmondani, melyik üzleti problémát érdemes modellé fordítani. Ez a fordítói képesség az, ami hiányzik a legtöbb helyen, és ez az, ami a leglassabban épül.
Ezért szokott jól működni a vegyes felállás: van egy belső ember, aki az üzletet érti és az adatokkal is elboldogul, mellette pedig külső csapat, amelyik a módszertani részt hozza. Így a tudás is marad a cégnél, és nem kell egy teljes data science csapatot felépíteni ahhoz, hogy az első projekt elinduljon.
Belépési pont nálunk:vállalati képzés a cég saját adatain és saját problémáin. A tapasztalat szerint sokkal jobban megragad, mint egy általános tananyag.
3. lépés, validáció: melyik folyamatot érdemes adatvezéreltté tenni?
Itt dől el a projekt sorsa, és ez a leggyakrabban átugrott lépés.
A kérdés kettős. Az egyik fele üzleti: melyik folyamat az, ahol egy jobb döntés mérhető pénzt hoz? Nem az, ahol a legizgalmasabb az adat, és nem az, ahol a legkönnyebb elkezdeni. A másik fele adatoldali: megvan-e egyáltalán az az adat, ami ehhez kell? Meglepően sokszor derül ki, hogy a szükséges információ létezik, csak nem ott, ahol keresték, vagy hogy éppen az a változó hiányzik, ami nélkül az egész nem megy.
Ebben a fázisban még alig történik tényleges adatelemzés. Amit vizsgálunk, az az, hogy az ötlet megvalósítható-e, és nagyjából mennyit érhet.
Két eszköz segít itt. Az adatvagyon-felmérés azt térképezi fel, milyen adatod van és mi hozható ki belőle. A data science projektek négy típusa pedig abban segít, hogy a kiválasztott feladatot a megfelelő projekttípusba soroljuk, mert a típus meghatározza az időtávot és a kockázatot is.
Egy tipikus eset a gyakorlatunkból: egy gyártó cégnél a kezdeti felvetés a selejtarány előrejelzése volt. A validáció során kiderült, hogy a selejt ritka, tehát kevés a tanulni való eset, viszont a gépleállások gyakoriak és jól dokumentáltak. A projekt végül a leállások előrejelzésére indult, és ez hozta a megtérülést. Az eredeti ötlet nem volt rossz, csak nem az volt a legjobb elsőnek.
Belépési pont nálunk:üzleti validációs workshop, tipikusan egy negyedév. A kimenete egy kiválasztott use-case és egy megtérülési becslés, amivel el lehet menni döntést kérni.
4. lépés, proof of concept és pilot: működött volna a múltban?
A proof of concept egyetlen kérdésre válaszol: ha ez a módszer már tavaly is futott volna, jobban jártunk volna? A historikus adatokon visszajátsszuk, mit javasolt volna a modell, és összevetjük azzal, ami ténylegesen történt. Ebből jön a megtérülési szám, amit a validációs fázisban még csak becsültünk.
Érdemes külön kezelni a proof of conceptet és a pilotot, mert nem ugyanaz:
Proof of concept
Pilot
Kérdés
Működött volna a múltban?
Működik az éles folyamatban?
Adat
Historikus
Élő
Ki használja?
A projektcsapat
A tényleges felhasználók
Mi derül ki?
Van-e a modellben érték
Beépíthető-e a napi munkába
A második oszlop az, amit a legtöbben kihagynak, pedig az adatprojektek jellemzően nem a modellen buknak el, hanem azon, hogy a javaslat nem illeszkedett a napi működésbe. Egy pontos modell, amit senki nem néz meg, nulla forintot ér.
Belépési pont nálunk:adatelemzés, tipikusan egy-két negyedév. A kimenete egy mért eredmény, nem egy ígéret.
5. lépés, rendszerépítés és üzemeltetés: ami a modell után jön
Ha a proof of concept azt mutatta, hogy a módszer működött volna, akkor jön a rendszer, ami folyamatosan futtatja. Ez a lépés szokott a vártnál összetettebb lenni, és ennek nem technológiai oka van.
Egy éles rendszernél ugyanis nem elég, hogy a modell jó volt a bevezetéskor:
Monitorozni kell. A valóság elmozdul a tanítóadattól, és a modell minősége ettől romlik. Ez nem hiba, hanem a dolog természete, csak észre kell venni.
Vissza kell mérni az értéket. Nem elég, hogy fut. Azt is látni kell, mennyit hozott, különben az első költségcsökkentési körben kikerül.
Bele kell illeszteni a folyamatba. Ki nézi meg a javaslatot, mi történik, ha felülbírálja, és hol látszik utólag, mi miért történt.
Ez a rész a CRISP-DM bevezetési fázisa, és ez az, ami az egész projektből a leghosszabb ideig tart, mert nincs vége.
Belépési pont nálunk:rendszerépítés és üzemeltetés, két negyedévtől felfelé. Ide tartozik az is, hogy a futó rendszert mi üzemeltetjük, ha a cégnek erre nincs saját csapata.
Honnan lesz adat, és mennyi kell?
Két különböző helyzet van, és érdemes tudni, melyikben vagy.
Az egyik: van adatod, csak nincs rendben. Ez a gyakoribb. Az ERP, a CRM, a gyártásirányítás, a szerviznaplók, a beszállítói levelezés mind adat, csak nem elemezhető formában. A kis- és középvállalatok rendszerint alábecsülik, mennyi használható adaton ülnek. Ilyenkor a munka nagy része az összegyűjtés és a rendbetétel.
A másik: nincs adat, mert nem mértétek. Ez lassabb út, mert előbb mérni kell kezdeni, és csak utána lehet elemezni. Az Ipar 4.0 eszközparkja (szenzorok, gépi adatgyűjtés) sok helyen pont ezt oldja meg.
A gépi tanuláshoz három dolog kell egyszerre:
KPI-szinten megfogalmazott üzleti probléma. Nem „legyünk hatékonyabbak", hanem „csökkentsük a késve érkező szállítmányok arányát".
Elegendő adat. Nem abszolút mennyiségben mérve: annyi, hogy a vizsgált jelenség elég sokszor előforduljon benne, és a szezonalitás is lefusson. Egy éves ciklusú üzletnél ez jellemzően több év.
A problémához illő modellezési keret. Ezt már nem a megrendelőnek kell tudnia.
Ahogy nő az érettség, úgy változik az is, mire használod az adatot:
Szint
Mit csinál?
Mire válaszol?
Leíró riport
Összegzi, ami történt
Mi történt?
Valós idejű dashboard
Mutatja, ami most van
Mi történik most?
Prediktív elemzés
Historikus mintákból előrejelez
Mi fog történni?
Optimalizáló rendszer
Javaslatot ad a döntésre
Mit tegyünk?
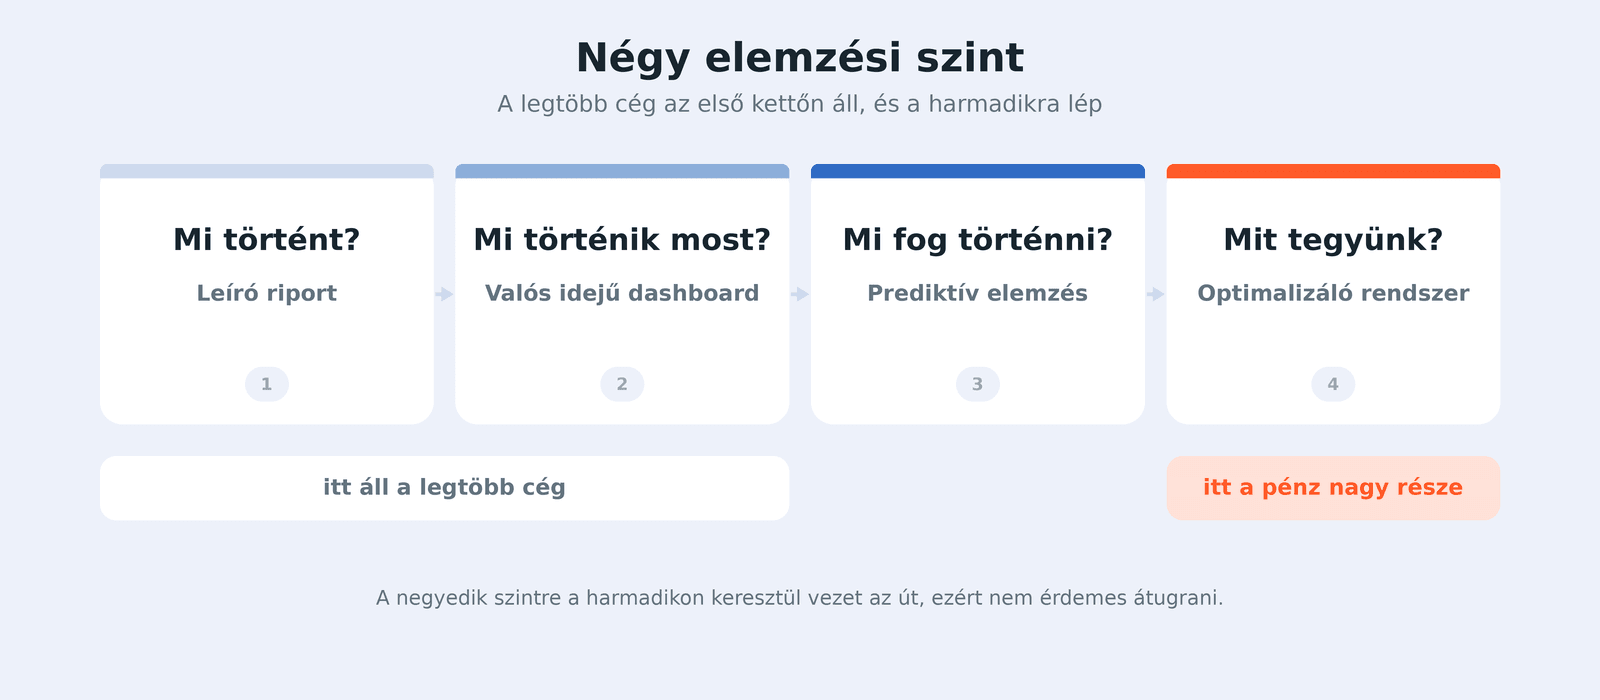
A legtöbb cég az első két szinten van, és a harmadikra lép. A negyedik az, ahol a pénz nagy része van, de oda a harmadikon keresztül vezet az út. Egy ilyen, végigvitt példa a Waberer's esettanulmányunk.
Mennyi idő alatt jön eredmény?
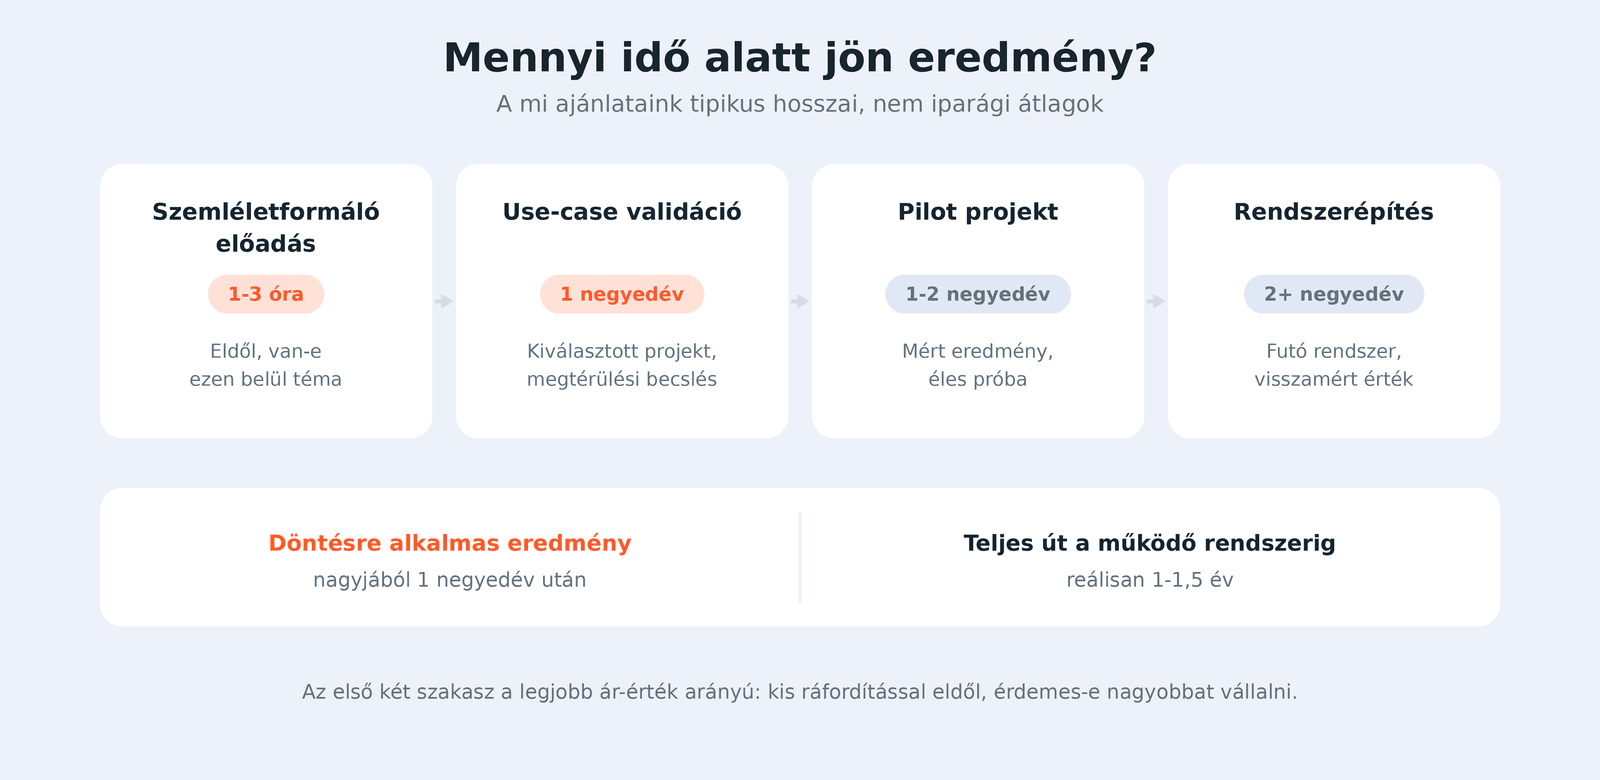
A teljes út, az első előadástól a működő rendszerig, reálisan egy-másfél év. Ez elsőre soknak hangzik, de félrevezető így nézni, mert döntésre alkalmas eredmény jóval hamarabb van: a validáció végén, nagyjából egy negyedév után már tudod, megéri-e belevágni és nagyjából mennyit hoz.
Szakasz
Tipikus hossz
Mi van a végén a kezedben?
Szemléletformáló előadás
1-3 óra
Eldől, van-e ezen belül téma
Use-case validáció
1 negyedév
Kiválasztott projekt, megtérülési becslés
Pilot projekt
1-2 negyedév
Mért eredmény, éles próba
Rendszerépítés
2+ negyedév
Futó rendszer, visszamért érték
Ezek a mi ajánlataink tipikus hosszai, nem iparági átlagok. Az első két sor egyébként a legjobb ár-érték arányú rész: kis ráfordítással eldől, hogy érdemes-e a nagyobb kötelezettséget vállalni.
Mit változtatott a generatív AI ezen a modellen?
A lépcsők nem változtak, a súlyuk igen.
Az első lépés olcsóbb lett. 2018-ban azzal telt egy előadás fele, hogy egyáltalán elhiggyék: ebből üzleti haszon lesz. Ma mindenki használt már chatbotot, tehát a lendület nem hiányzik. Ez jó hír.
A második lépés viszont félrevezetőbb lett. Abból, hogy valaki ügyesen promptol, még nem következik, hogy meg tudja ítélni, mikor megbízható egy modell kimenete. A generatív eszközök használata és a data science kompetencia két külön dolog, és könnyű összekeverni őket.
A harmadik lépés fontosabb lett, nem kevésbé. Ma két hét alatt össze lehet rakni egy demót, ami jól néz ki. Éppen ezért könnyebb átugrani azt a kérdést, hogy a demó olyan problémát old-e meg, ami pénzt hoz. A validáció régen azért volt szükséges, mert a fejlesztés drága volt. Ma azért, mert olcsó.
Az ötödik lépés maradt a legnehezebb. A modell működésének folyamatos ellenőrzése, a visszamérés, a folyamatba illesztés pontosan ugyanolyan munka, mint nyolc éve. A McKinsey számai is ezt mutatják: a használat majdnem általános, a skálázás 44 százalék, az érdemi eredményhatás 6 százalék.
Egy új elem viszont bejött a képbe: a szabályozás. Az AI Act bizonyos felhasználásoknál dokumentációt és emberi felügyeletet ír elő, ezért a bevezetés tervezésekor ma már a felelős AI kérdéseit is végig kell gondolni, nem csak utólag.
Gyakori kérdések
Hogyan kezdje el egy cég az AI bevezetését?
Az első lépés nem technológiai, hanem az, hogy legyen egy elkötelezett döntéshozó és egy nyitott csapat. Ezután jön a kompetencia (belső tudás vagy külső partner), majd annak eldöntése, melyik folyamatot érdemes elsőként adatvezéreltté tenni. Csak ezután van értelme fejleszteni.
Melyik lépést szokták átugrani?
A harmadikat, a validációt. Ez azért veszélyes, mert a kihagyásával a fejlesztés egy véletlenszerűen kiválasztott problémára indul el, és a megtérülés kérdése csak a végén merül fel, amikor már elköltöttétek a pénzt.
Mennyi adat kell egy AI-projekthez?
Nincs univerzális szám. A gyakorlati szabály az, hogy a vizsgált jelenség elég sokszor forduljon elő az adatban, és a teljes szezonalitás fusson le benne. Éves ciklusú üzletnél ez jellemzően több év adatát jelenti. Ritka eseményeknél (például selejt) sokszor az derül ki, hogy más, gyakoribb jelenséget érdemes előre jelezni.
Mennyi idő, amíg eredmény lesz?
A teljes út az első előadástól a működő rendszerig reálisan egy-másfél év. Döntésre alkalmas eredmény viszont már a validációs szakasz végén, nagyjából egy negyedév után van: onnantól tudod, megéri-e folytatni.
Kell saját adattudós csapat?
Az induláshoz nem. A leggyakrabban működő felállás az, hogy van egy belső ember, aki az üzletet érti és az adatokkal is elboldogul, mellette pedig külső csapat hozza a módszertani részt. Saját csapatot akkor érdemes építeni, ha már több futó rendszered van.
Mi a különbség a proof of concept és a pilot között?
A proof of concept historikus adaton azt vizsgálja, hogy a módszer működött volna-e a múltban. A pilot élesben, valódi felhasználókkal azt, hogy beilleszthető-e a napi működésbe. A második legalább olyan fontos, mert a projektek többsége nem a modellen bukik el, hanem a beillesztésen.
Változtatott ezen bármit a generatív AI?
A lépések sorrendjén nem. Annyi változott, hogy a lendület olcsóbb lett, a kompetencia megítélése nehezebb (a promptolás nem data science), a validáció pedig fontosabb, mert ma gyorsan lehet jól kinéző demót építeni olyan problémára is, ami nem hoz pénzt.
Melyik lépcsőn állsz most?
A modell akkor hasznos, ha megnézed, hol tartotok, és arra koncentráltok. Aki a harmadik lépcsőn van, annak nem előadás kell, hanem use-case. Aki a negyediken, annak nem képzés, hanem mérés.
Ha nem egyértelmű, melyik lépcső a tiétek, az önmagában is válasz: jellemzően azt jelenti, hogy a validáció hiányzik.
Igyunk meg egy kávét, és fél óra alatt kiderül, melyik lépéssel érdemes indulnotok.
Leíró, diagnosztikus, prediktív vagy preskriptív: négy projekttípus, négy különböző üzleti kérdésre. Táblázattal és valós projektpéldákkal ahhoz, hogy eldöntsd, a céged melyikkel induljon.
Az adatprojektek nem a technológián buknak el, hanem emberi és szervezeti okokon. A hét leggyakoribb buktató, a hetedik sikerkritérium, amiről ritkán esik szó, és az a három lépés, amivel a kockázat a töredékére csökkenthető.
A CRISP-DM hat fázisa nem elmélet, hanem az a sorrend, amiben egy adatprojekt nem szalad félre. Végigvisszük egy banki hitelkártya-kampányon, megmutatjuk, hová megy el az idő, és hogy mi változott a bevezetés fázisában az MLOps korában.